Créer du contenu original avec l'IA (sans tomber dans l'AI slop)
L'IA ne crée pas de contenu original : elle démultiplie ce que vous avez déjà. La méthode en 4 temps (donnée propriétaire, perspective éditoriale, format long, démultiplication) à l'origine de 90 % de mes clients en 2 ans.
Colin Dargent
Mis à jour le
Le replay
Vous demandez à l’IA d’écrire un post. Le résultat est propre, bien structuré, et interchangeable avec celui de n’importe quel concurrent. C’est ça, l’AI slop.
Pour moi, c’est l’inverse. Ça fait plus de deux ans que je trouve la majorité de mes clients par le contenu que je publie : 90 % sur cette période. Ce guide reprend le webinaire où j’ai détaillé comment, avec la méthode en 4 temps que j’applique chaque semaine.
Le vrai problème avec « IA x contenu »
Le raccourci « IA x contenu = AI slop » n’est pas complètement faux. Il est juste mal posé.
Le contenu, c’est une compétence comme une autre. Si vous demandez à l’IA d’en produire sans base, sans données, sans rien, le résultat sera forcément générique, comme n’importe quel travail bâclé. Ce n’est pas l’IA le problème : c’est l’absence de matière première.
J’ai testé la voie inverse en 2025 : faire rédiger mes posts entièrement par l’IA. Ça n’a jamais vraiment fonctionné, au point que je suis revenu à l’écriture manuelle. Ce qui a changé en 2026, ce n’est pas un meilleur prompt : c’est une meilleure organisation de ma donnée, avec l’arrivée d’Opus 4.6 et le concept de second cerveau.
Le bon ordre : la donnée d’abord, l’IA en dernier
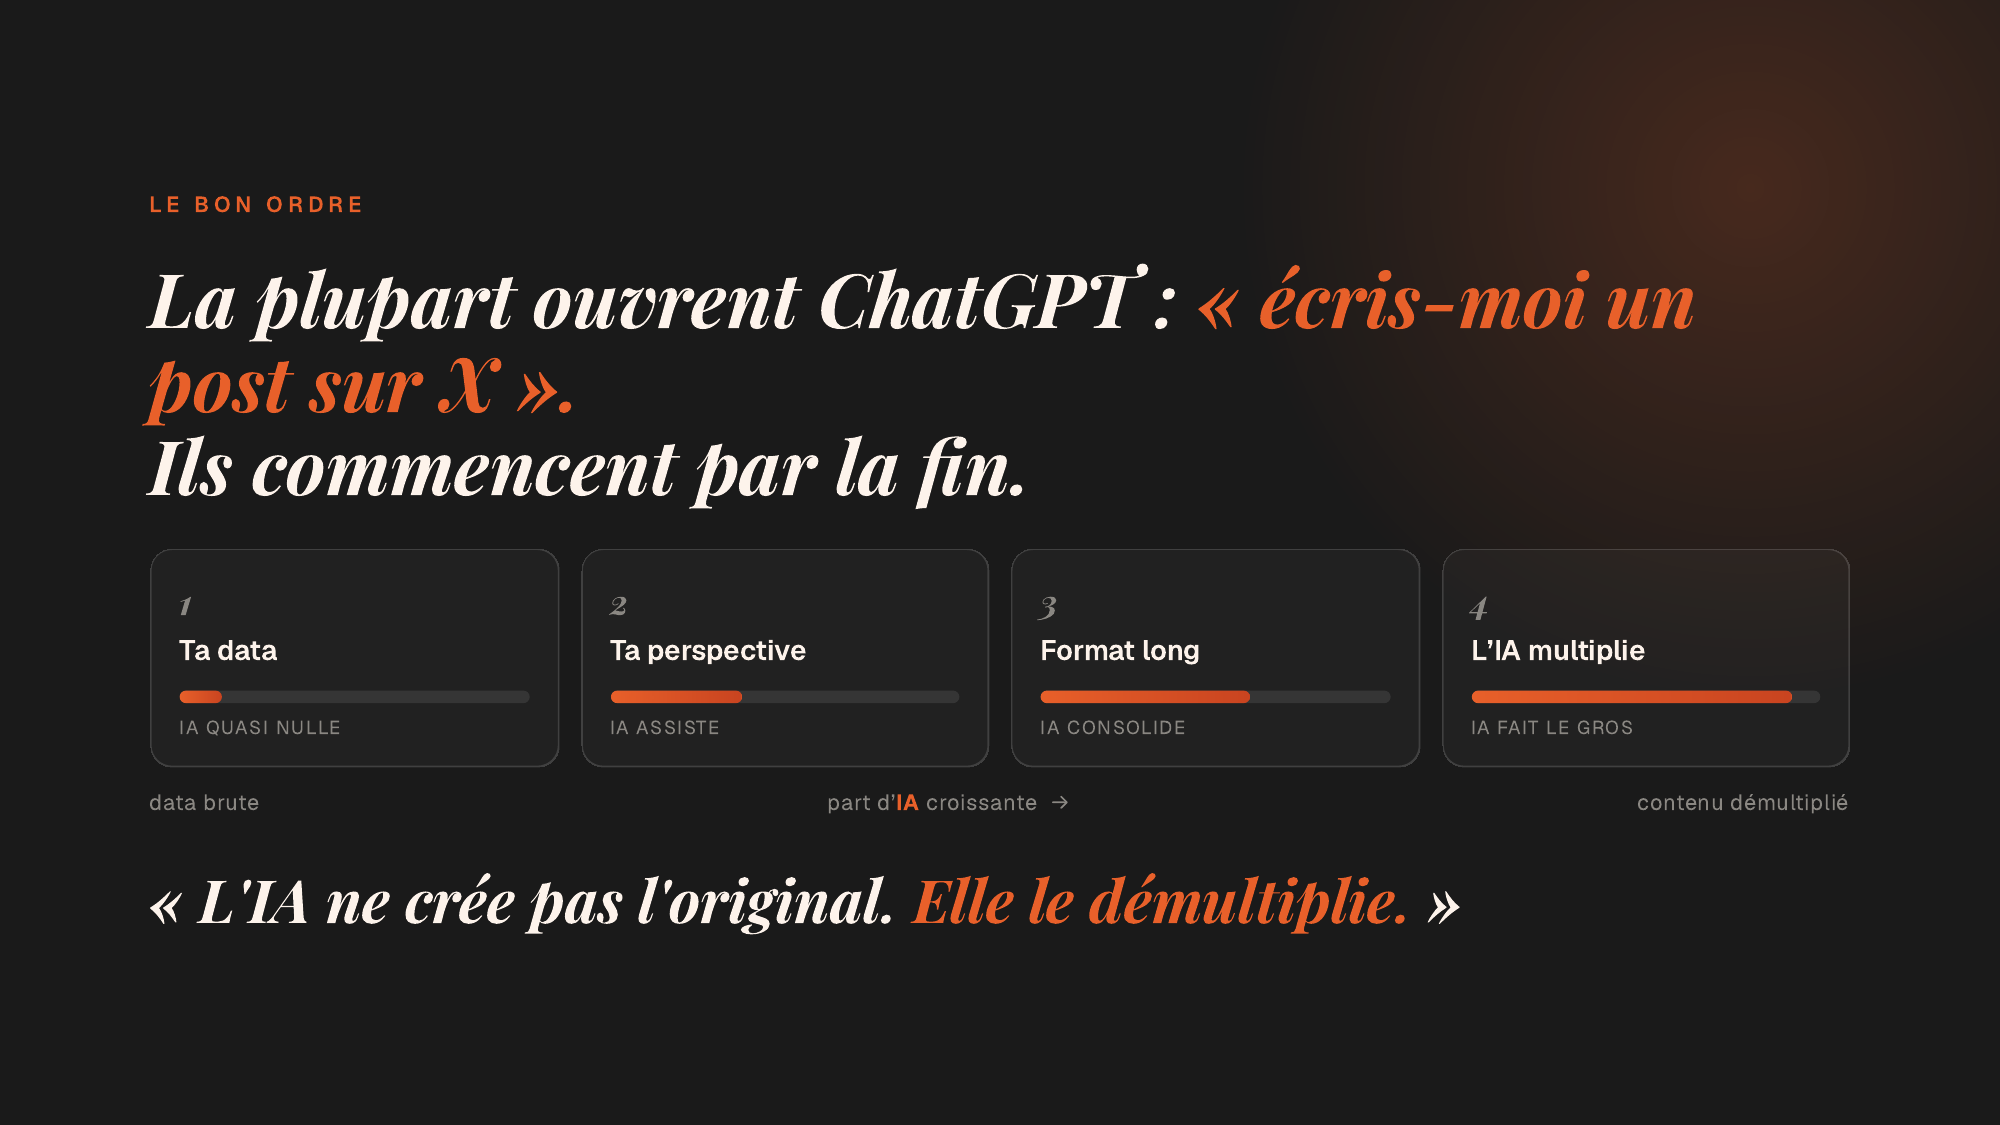
La plupart des gens ouvrent ChatGPT et tapent « écris-moi un post sur X ». Ils commencent par la fin.
Ma méthode tient en 4 étapes, et l’ordre est ce qui compte le plus : votre donnée propriétaire, votre perspective éditoriale, un format long qui consolide les deux, et seulement à la fin, l’IA qui démultiplie tout ça. La part d’IA grossit à chaque étape, mais elle arrive toujours en dernier.
Centraliser sa donnée propriétaire
Être IA-first, c’est d’abord être data-first. Et la bonne nouvelle, c’est qu’on produit tous de la donnée propriétaire, tous les jours, sans avoir besoin de dix ans d’historique. Il suffit de la capter au lieu de la jeter.
Je m’appuie sur 5 sources :
- Les meetings. J’enregistre 100 % de mes réunions, distanciel comme physique.
- Les projets clients. Chaque projet devient une donnée structurée : qui est le client, ce qu’on lui a livré, quel résultat, quel problème rencontré. Ça sert trois fois : au contenu, à la connaissance interne (éviter de refaire ce qu’on a déjà produit), et à la remontée d’études de cas en prospection.
- La veille, choisie à la main. J’ai abandonné la veille automatisée agrégée, jamais relue. Un skill nommé « Ingest » récupère un contenu que je juge pertinent, en garde le lien source, et n’enregistre que les insights qui m’intéressent, jamais le texte brut intégral.
- Les feedbacks clients.
- Les échanges écrits.
Cette matière ne doit pas devenir une charge de travail supplémentaire : c’est un système qui capte et organise ce que vous produisez déjà. Structurer cette donnée avant de brancher des agents dessus n’est pas une option, c’est un prérequis (j’en parle plus en détail dans Données IA PME : le prérequis oublié avant vos agents).
Construire sa perspective éditoriale
La donnée seule ne suffit pas. Il faut un filtre pour la transformer en contenu original : c’est votre perspective.
Pour moi, ça se résume à une conviction (« IA-first égale data-first »), un ton praticien à la première personne, et le refus de vendre du rêve ou de faire des promesses irréalistes. Un agent vérifie 10 critères de ce type sur chaque contenu que je produis, avant publication.
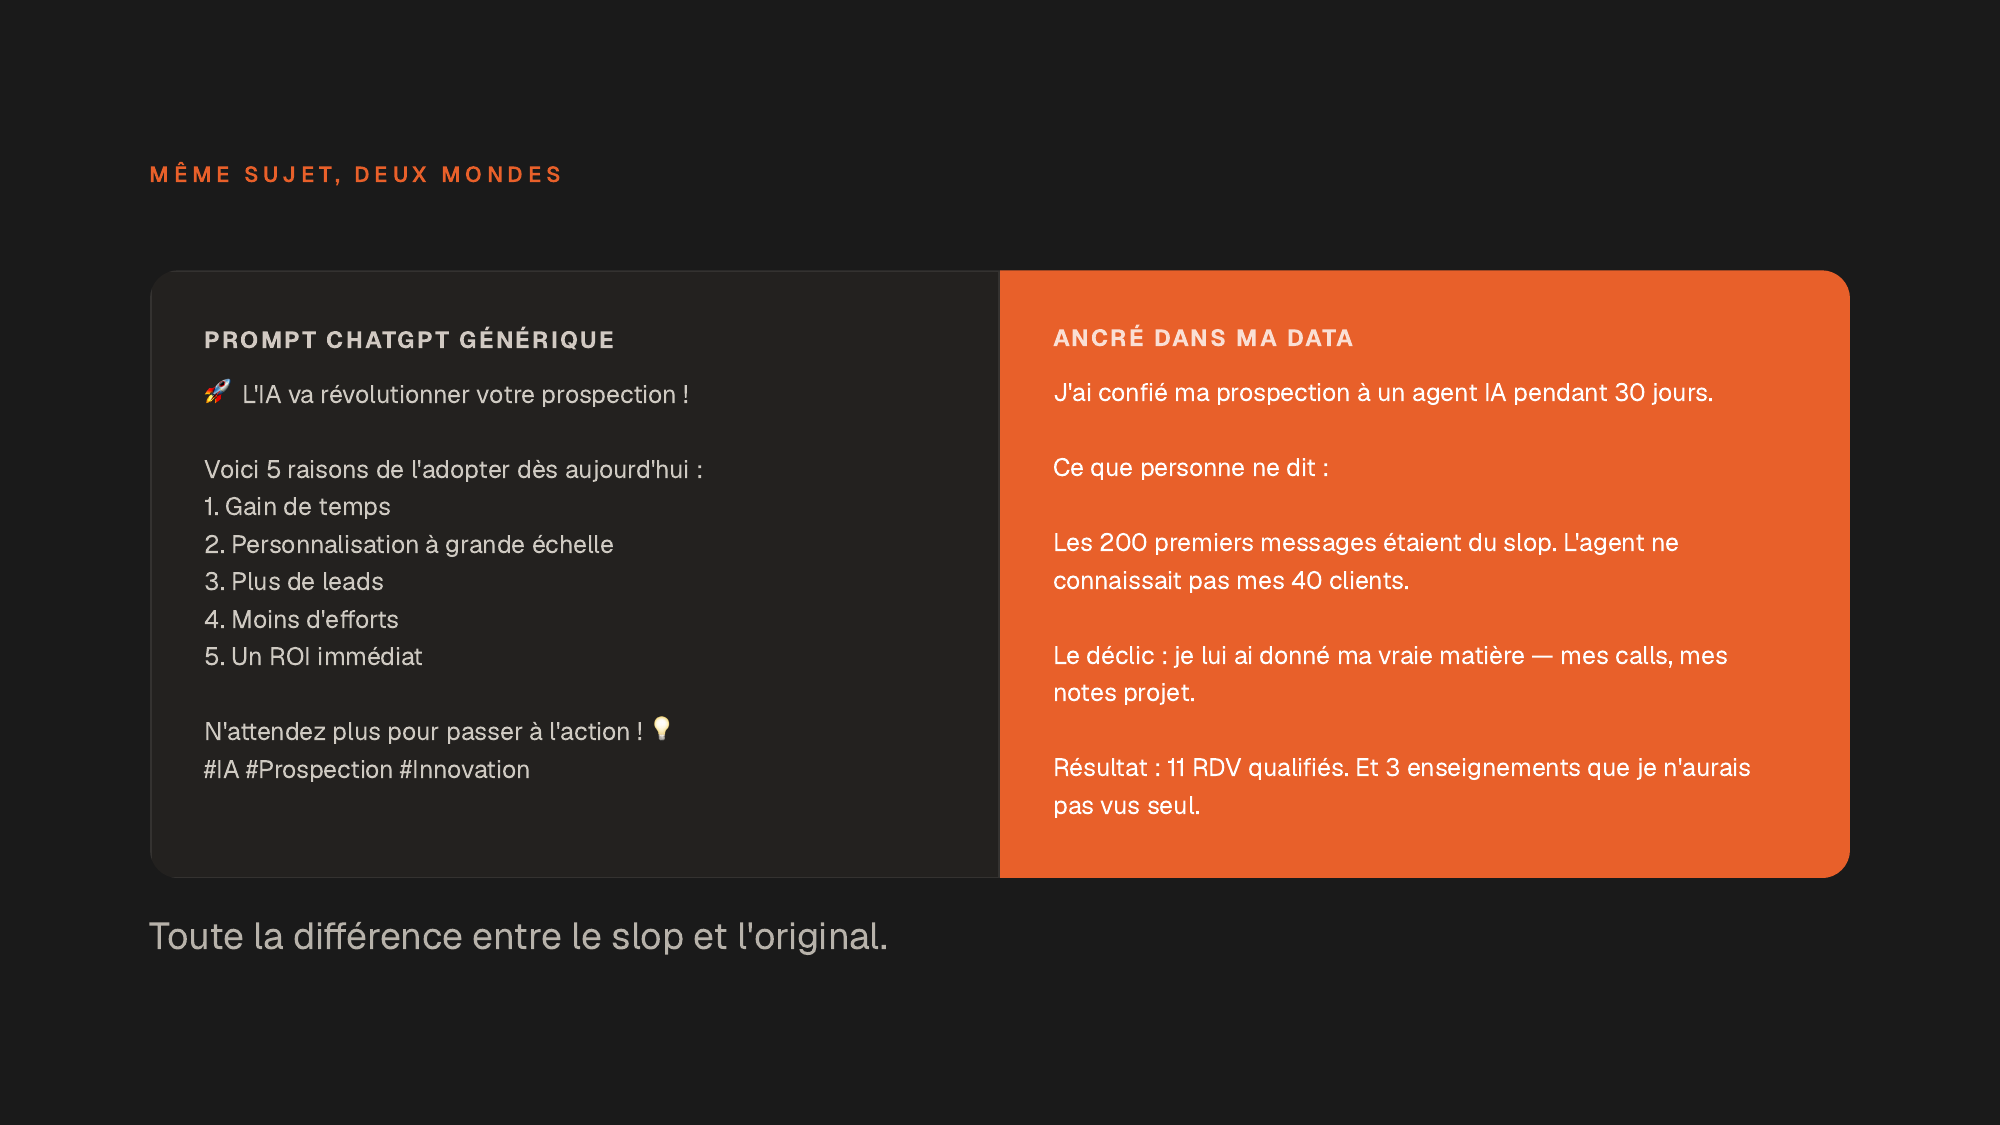
Même sujet, deux mondes : un prompt générique produit un texte interchangeable ; un contenu ancré dans une vraie expérience, avec ses chiffres et ses enseignements concrets, ne peut être écrit par personne d’autre que vous.
Un test simple pour juger si un positionnement est assez spécifique : si vous pouvez le coller à un studio de yoga et que ça fonctionne encore, ce n’est pas assez original.
C’est aussi pour ça que je garde la main sur mes posts LinkedIn, même si un skill pourrait les générer seul : ça me force à conscientiser mes apprentissages, et ça me sert d’instrument de marché pour sentir ce qui parle vraiment à mes clients.
Vous ne savez pas encore quelle est votre perspective ?
C’est souvent le vrai blocage avant même la donnée. En 30 minutes, on identifie ensemble votre angle et la matière que vous avez déjà pour l’étayer.
Découvrir comment mon entreprise peut devenir IA native →Le format long : la source qui alimente tout le reste
Un format long (podcast, newsletter, webinaire) est le meilleur « single input » : une à trois heures de travail peuvent produire une à deux semaines de contenu.
Ce webinaire en est la preuve par l’exemple : je n’ai rien eu à créer de zéro pour le préparer. C’est le même système que j’utilise chaque jour, celui que je vous présente ici. Le vrai travail a été de le structurer, pas de le créer.
C’est aussi pour ça que j’ai créé un skill qui part du replay d’un webinaire pour produire automatiquement des clips, un guide comme celui que vous lisez, et de la matière pour d’autres posts.
Démultiplier avec l’IA (sans perdre l’original)
Une fois la donnée, la perspective et le format long en place, l’IA peut enfin multiplier et distribuer : transformer une pièce longue en clips, en articles, en déclinaisons pour d’autres réseaux.
J’ai par exemple un agent qui rédige chaque semaine un article sur la base de mon second cerveau, avec zéro intervention de ma part : il regarde les nouveaux contenus apparus dans mon vault et choisit son sujet selon le volume de mots-clés des thématiques qu’il en extrait. Ce niveau d’autonomie ne se décrète pas du jour au lendemain, il se calibre progressivement (voir L0 à L4 : calibrer l’autonomie d’un agent IA en PME).
Ce socle permet aussi de tester des formats à coût quasi nul, comme mes actus IA du dimanche, devenues 100 % automatisées après quelques essais. Et ça referme la boucle : le contenu génère des leads, les leads deviennent des clients, les clients apportent plus de données propriétaires, qui nourrissent encore plus de contenu.
Envie du même système, mais pour votre activité ?
La méthode est la même, mais la donnée et la perspective sont uniques à chaque entreprise. On regarde ensemble comment l’appliquer chez vous.
Découvrir comment mon entreprise peut devenir IA native →Cartographier son système d’information avant l’IA
Une question posée en direct pendant le webinaire mérite d’être développée : arrêter de jeter sa matière, ça reste avant tout un sujet d’organisation.
Avant même de parler d’IA, il faut définir où vit chaque information dans votre entreprise : telle donnée dans telle base, telle autre dans tel dossier. Ça n’a pas besoin d’être dans un outil comme Obsidian, mais ça doit être codifié et accessible à tous les collaborateurs qui utilisent l’IA. C’est le premier chantier, avant même de faire collaborer qui que ce soit avec un agent (je détaille ce principe de couche commune dans Couche data commune pour agents IA : l’architecture pivot).
Plus une entreprise grandit, plus ce travail de cartographie est complexe, mais le principe reste identique : un prompt système global, donné à tous les collaborateurs sur les plans entreprise (Claude ou ChatGPT), qui indique où chercher et où ranger chaque type d’information. Ce n’est pas réservé aux indépendants.
Bien choisir ses outils de veille : LinkUp vs Appify
La veille reste pertinente à automatiser dans deux cas précis : le cadre réglementaire (objectif, basé sur des critères clairs) et l’actualité concrète de votre secteur. Elle fonctionne moins bien pour juger la pertinence d’une expertise ou d’un leader d’opinion : ça reste difficile à évaluer pour une IA.
Deux outils reviennent souvent dans mes recommandations, et ils ne font pas la même chose. Appify est un scraper pur : il récupère le contenu brut d’une page ou d’une plateforme. LinkUp va une étape plus loin : il répond en langage naturel à partir d’une recherche web, et fournit les sources qu’il a scannées pour construire sa réponse. Un endpoint en bêta permet même de vérifier si une information précise figure sur une URL donnée.
On est aux prémices
Ce système n’a rien de définitif. Il s’est construit sur deux ans, par itérations, avec des phases qui n’ont pas fonctionné avant de trouver ce qui marche. Vous n’avez pas besoin de reproduire mon vault pour commencer : juste d’arrêter de jeter la matière que vous produisez déjà.
J’interviens sous deux modalités selon où vous en êtes : en coaching, pour monter en compétence individuellement avec l’IA, ou en accompagnement opérationnel, pour mettre en place ce type de système directement dans votre entreprise.
La présentation du webinaire
Vous préférez les slides ? La présentation complète est disponible en téléchargement.
Télécharger la présentation (PDF)
Prêt à construire votre propre système de contenu ?
On regarde ensemble votre donnée, votre perspective, et le premier format qui peut tout démultiplier. Sans engagement.
Découvrir comment mon entreprise peut devenir IA native →FAQ
Comment savoir quoi garder de sa veille, sans tout stocker ?
Je garde toujours le lien de la source. Pour un article, je scrape le texte ; pour une vidéo, je récupère le transcript YouTube. Ensuite, je ne conserve que les insights que je juge pertinents pour mon activité, jamais le contenu brut intégral : si j’ai besoin d’y revenir, le lien original suffit à le retrouver.
Ce système de second cerveau est-il réplicable dans une entreprise plus grande, ou juste pour un indépendant ?
C’est plus complexe à mesure que la taille grandit, mais le principe reste le même : cartographier où vit chaque information et le codifier. Un indépendant peut utiliser un vault local en Markdown, le format le plus accessible pour l’IA. Une entreprise peut répliquer l’idée avec ses drives, son CRM et un prompt système global donné à tous les collaborateurs, qui indique où chercher et où ranger chaque type d’information.
Combien coûte un système de contenu piloté par l’IA ?
Tout mon système tient sur un abonnement Claude à 90 euros par mois. C’est une question de retour sur investissement : l’IA permet de tester rapidement plusieurs formats à coût quasi nul, puis de garder ceux qui génèrent des leads ou du trafic et d’éliminer les autres.
LinkUp ou Appify : lequel choisir pour sa veille ?
Appify est un scraper pur : il récupère le contenu brut d’une page. LinkUp va plus loin : il ingère et synthétise en langage naturel, et fournit les sources scannées pour arriver à sa réponse. Un endpoint bêta permet même de vérifier si une information précise est présente sur une URL donnée. Je recommande LinkUp pour la veille réglementaire, concurrentielle ou sectorielle ; Appify reste utile pour du scraping brut.
Faut-il surveiller Slack et WhatsApp pour capter la donnée de ses échanges clients ?
Pas besoin d’aller aussi loin que Y Combinator, qui enregistre tout, micros dans les bureaux compris. De mon côté, j’enregistre 100 % des meetings, mais seulement les emails avec mes clients pour l’instant. Pour WhatsApp, j’utilise Unipile en ne surveillant que les conversations one-to-one avec mes clients, jamais les groupes : c’est là que l’information reste exploitable.
Vous voulez avancer ?
On construit les systèmes IA
que vos équipes pilotent.
Deux praticiens IA-natifs. Des résultats tangibles, chaque semaine.