Comment créer le second cerveau de votre entreprise
Un second cerveau individuel plafonne à votre productivité. La méthode pour le déployer à l'échelle de l'entreprise : structure du dossier, infrastructure Google Drive, les deux pièges et les règles pour le faire vivre. Sans compétences techniques.
Colin Dargent & Achille Morin-Lemoine
Mis à jour le
Le replay
Vous utilisez peut-être déjà un second cerveau : un dossier de fichiers texte qu’Obsidian ou Claude Code lit, et qui donne à l’IA tout votre contexte. Ça marche très bien. Mais ça plafonne à votre productivité individuelle.
À l’échelle d’une entreprise, le problème change de nature. La plupart des boîtes tournent sur du contexte qui n’est écrit nulle part. Pourquoi on a arrêté de travailler avec ce type de client ? La réponse est dans la tête d’une personne en congé maternité. Comment on répond à une demande entrante ? Dans un fil Slack de mars. Qu’est-ce qu’on a promis à ce client il y a six mois ? Dans un mail que personne ne retrouve.
Résultat : chaque session IA repart de zéro. Vous payez un problème de contexte. Ce guide reprend le contenu de notre quatrième webinaire : la méthode pour déployer un second cerveau à l’échelle de votre entreprise, quel que soit le niveau de départ de vos équipes.
Pourquoi le second cerveau individuel ne tient pas en entreprise
Les modèles existants sont pensés pour une seule personne. Quand on travaille en équipe, il n’y a pas que le contexte personnel de chacun : il y a les process communs et tous les contextes individuels qui doivent s’additionner pour collaborer.
L’infrastructure technique qu’on associe au second cerveau (Obsidian, Git, la ligne de commande) fonctionne quand on est peu nombreux et à l’aise avec ces notions. Dans une organisation plus classique ou plus grande, tout le monde n’a pas le même niveau de technicité. Très vite, c’est le bazar, et une entropie naturelle ramène chacun à ses silos de connaissances individuels.
Deux gestes, dans cet ordre : cartographier, puis documenter
La transition du modèle individuel au modèle collectif commence par deux actions.
Cartographier : retrouver l’information qui existe déjà. Où vit la donnée de votre boîte aujourd’hui ? Le CRM, les drives éparpillés, les boîtes mail, Slack. Une carte mentale ou un brouillon suffit. C’est une demi-journée de travail que personne ne fait jamais.
Documenter : créer l’information qui manque. En cartographiant, vous allez découvrir que personne n’a écrit ce process commercial que tout le monde applique à peu près. Il va falloir le poser noir sur blanc.
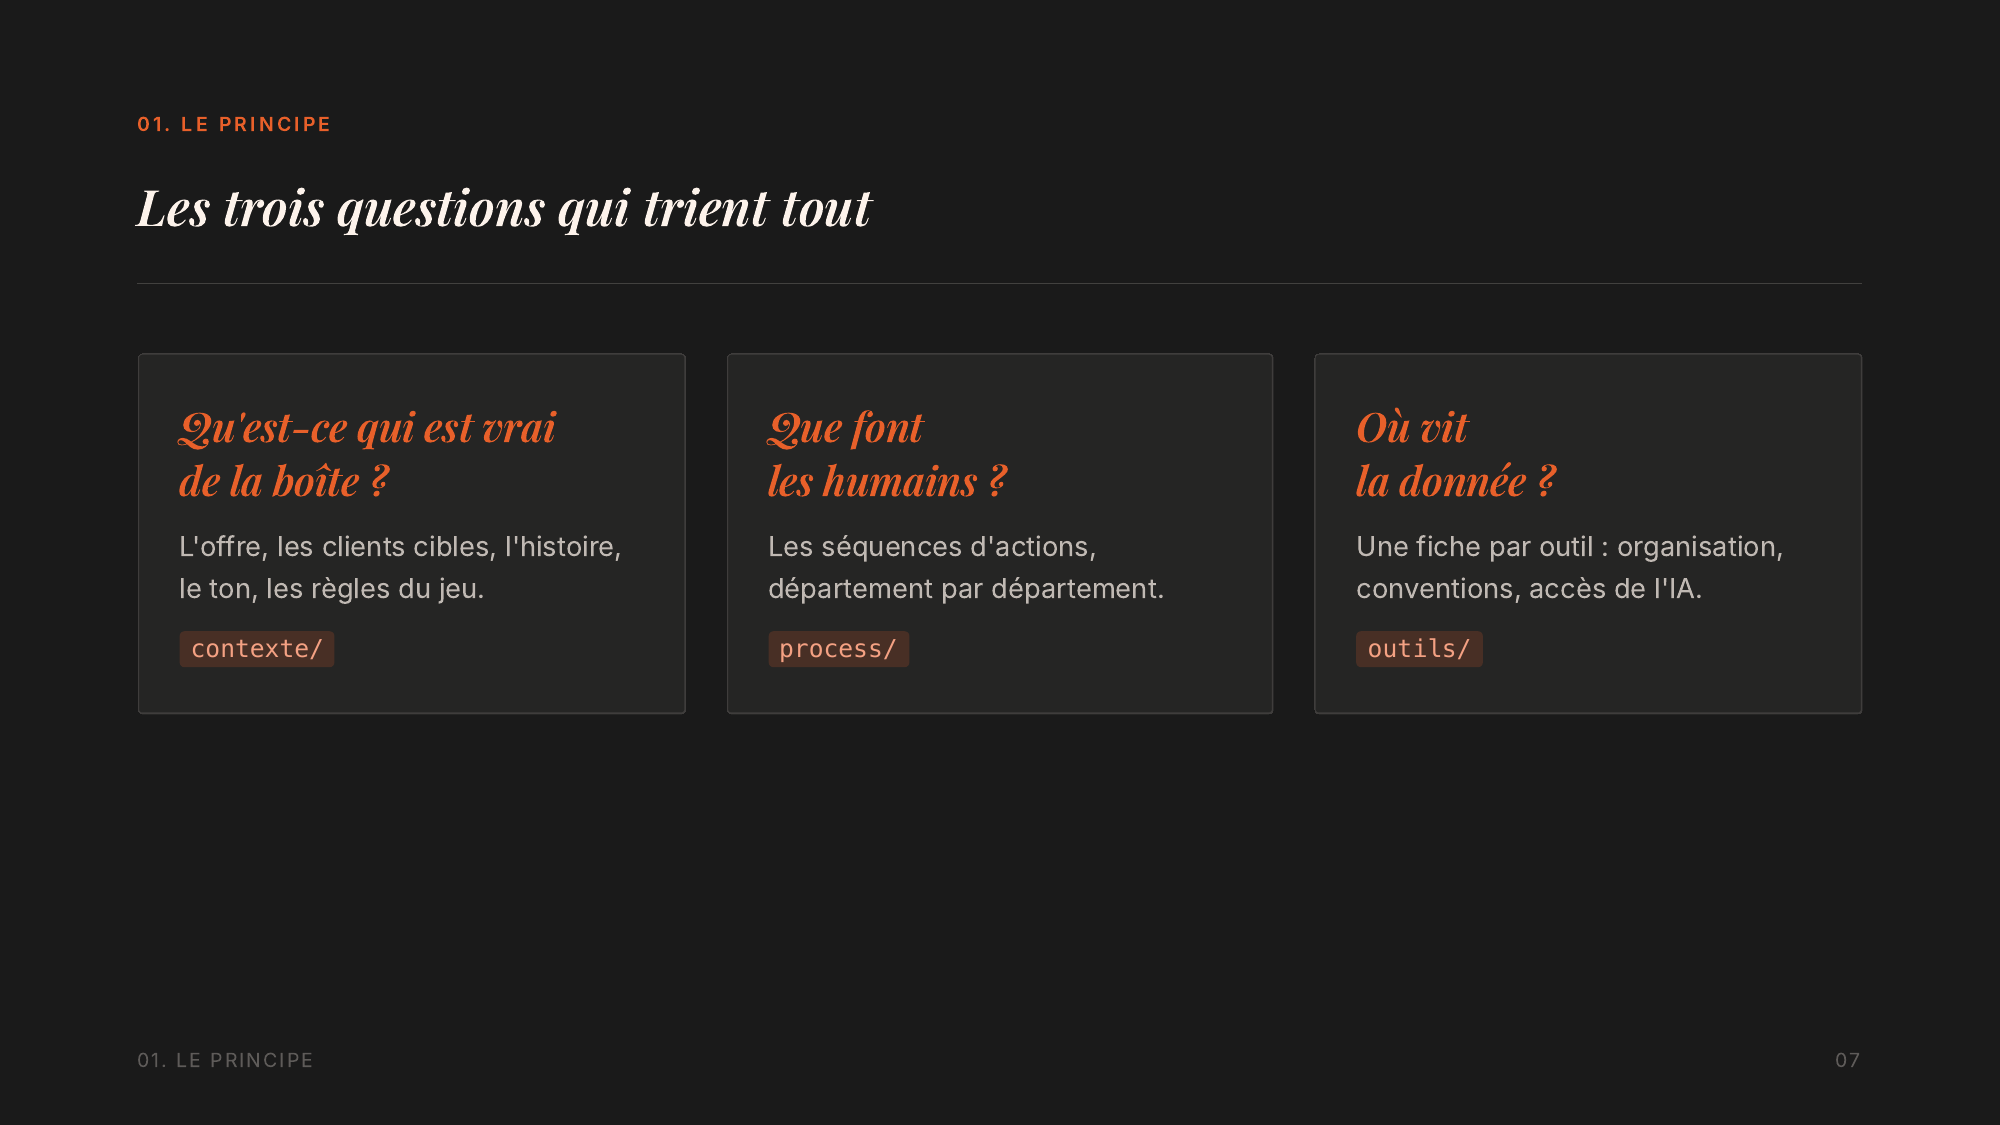
Trois questions structurent tout le travail :
- Qu’est-ce qui est vrai de la boîte ? L’offre, les clients cibles, l’histoire, le ton, les règles du jeu. C’est le dossier
contexte/. - Que font les humains ? Les séquences d’actions, département par département. C’est le dossier
process/. - Où vit la donnée ? Une fiche par outil : organisation, conventions, et comment l’IA y accède. C’est le dossier
outils/.
Un point de posture avant d’aller plus loin : ce second cerveau est écrit pour une IA. Demandez ce qu’une IA va faire d’un document. Il doit être bien conventionné pour une IA (fichiers Markdown, architecture claire).
La structure : un dossier neuf, à part
Le second cerveau d’entreprise est un nouveau dossier qui s’ajoute à côté de votre Drive. Zéro migration, zéro renommage, zéro fichier déplacé : l’entreprise garde son organisation exactement comme avant. Ce dossier donne la carte et le contexte sur tout le reste, il ne le remplace pas.
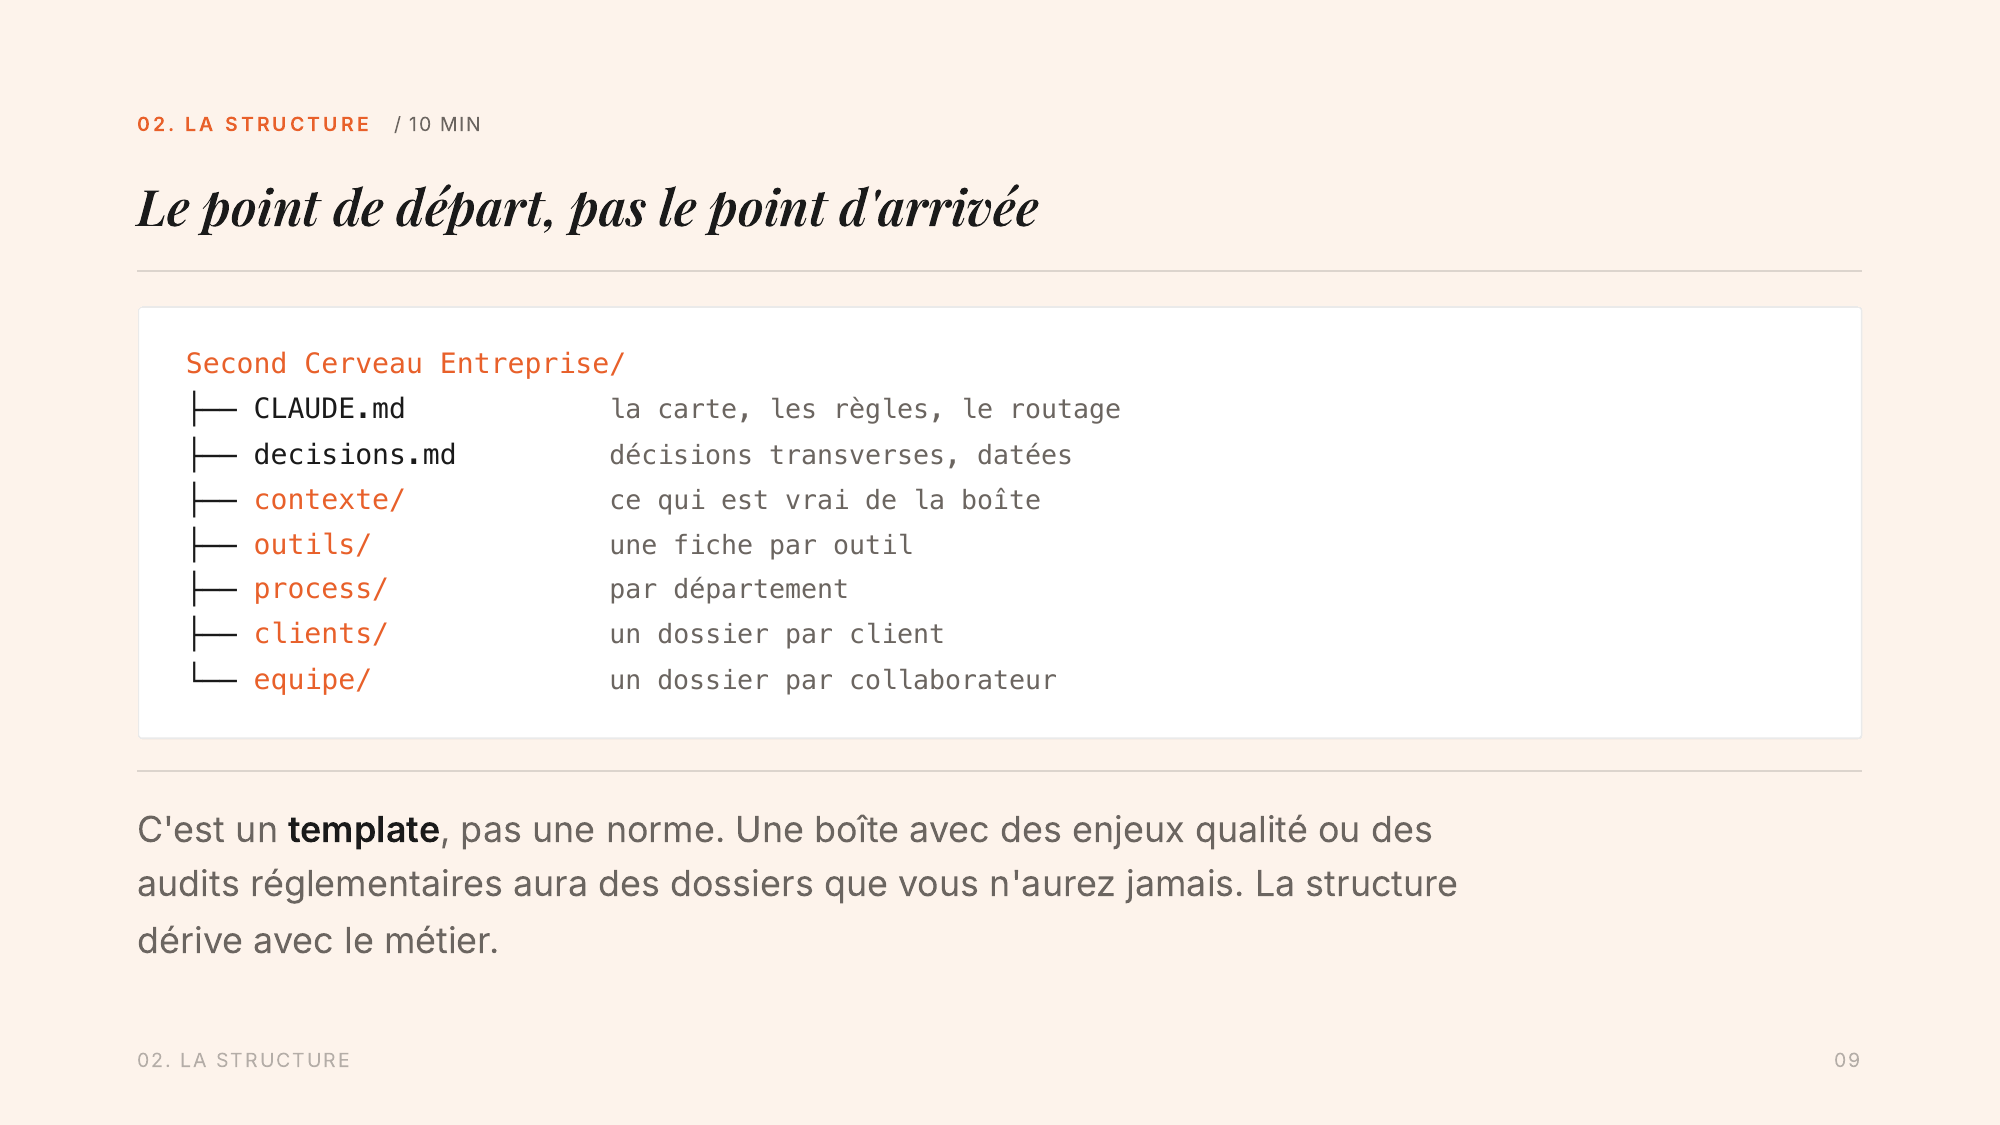
Le template s’articule autour de cinq briques :
contexte/: ce qui est vrai de l’entreprise. Son histoire, sa clientèle cible, ses offres, ses spécificités.outils/: une fiche par outil utilisé, qui documente le type d’informations qui s’y trouvent et la manière dont elles sont organisées. Chaque fiche dit une chose que personne n’écrit jamais : comment l’IA atteint cet outil.process/: le seul dossier découpé par département. Contexte, outils et clients sont transverses ; les process sont propres à chaque équipe.clients/: un dossier par client, qui retrace l’historique complet de la collaboration de manière synthétique. Pas chaque mail : chaque décision, chaque projet, chaque étape.equipe/: un dossier par collaborateur, où chacun organise sa gestion de la connaissance sur son périmètre.
À la racine et dans chaque dossier principal vit un fichier CLAUDE.md (ou agents.md chez ChatGPT, la mécanique est devenue standard). Ce fichier porte les règles en vigueur à cet endroit et route vers les process concernés. L’IA le charge automatiquement dès qu’elle entre dans le dossier, comme des poupées russes de plus en plus précises. Vous écrivez la règle une fois, à l’endroit où elle s’applique, et vous ne la répétez plus dans chaque prompt. (Si Claude Code ne vous est pas familier, notre guide en 7 étapes couvre cette mécanique en détail.)
Le socle est commun, la personnalisation est chez chacun : chaque collaborateur configure aussi son CLAUDE.md personnel, à la racine de son propre Claude, pour que l’IA sache qui il est sans qu’il ait à se présenter à chaque session.
C’est un template. Une boîte avec des enjeux réglementaires aura des dossiers que vous n’aurez jamais. La structure dérive avec le métier. C’est le même principe de fond que la couche data commune pour agents IA : on fait le travail de structuration une fois, on construit dessus.
L’infrastructure : une échelle, pas un choix
Trois niveaux existent, du plus simple au plus technique.
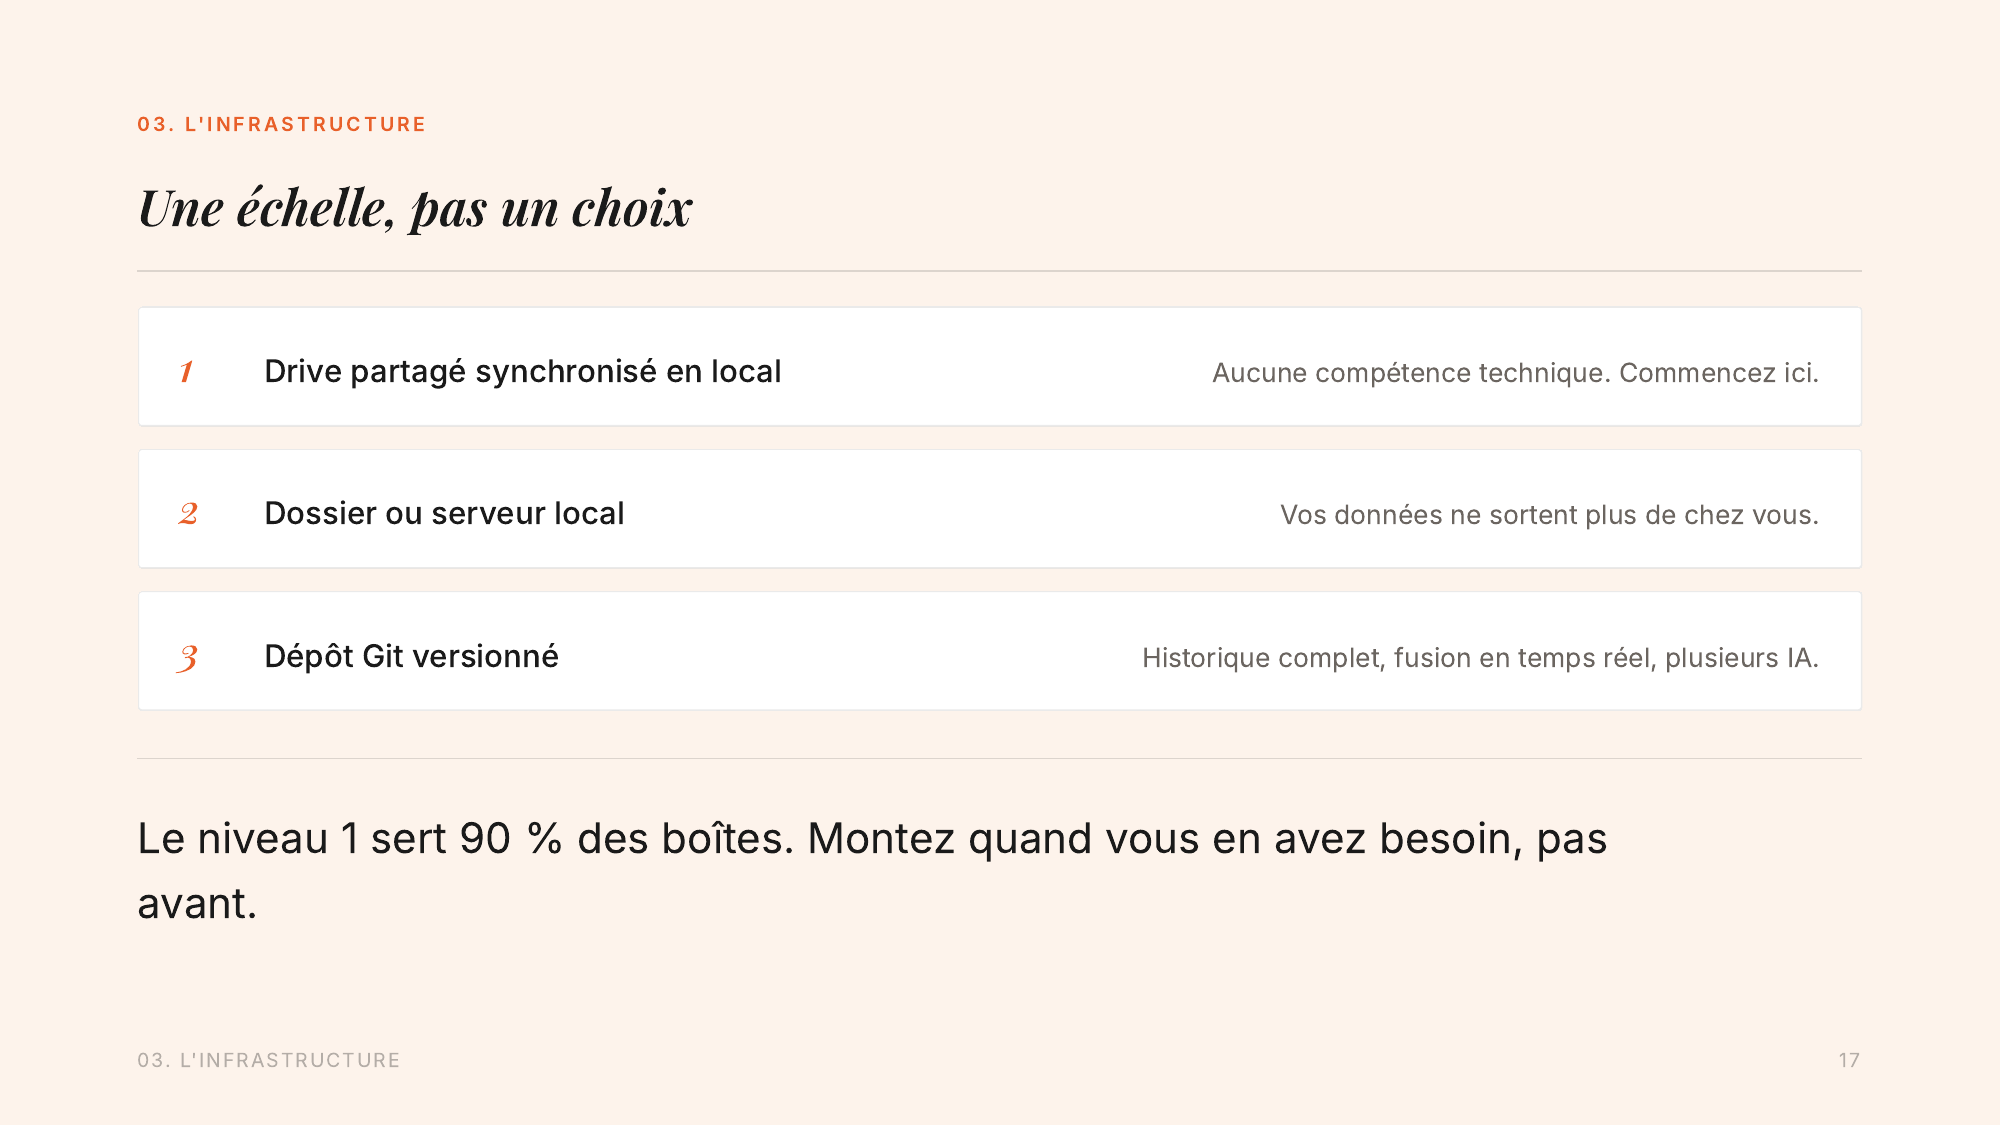
- Un Drive partagé synchronisé en local (Google Drive, OneDrive, Dropbox). Aucune compétence technique requise. C’est là qu’on recommande de commencer.
- Un dossier ou serveur local d’entreprise. Vos données ne sortent plus de chez vous, mais c’est moins automatique : c’est en général votre responsable technique qui gère.
- Un dépôt Git versionné. Historique complet de chaque modification, fusion en temps réel, plusieurs IA. Génial, mais réaliste seulement pour des petites équipes à l’aise techniquement.
Le niveau 1 suffit pour commencer. Montez d’un niveau quand le besoin apparaît.
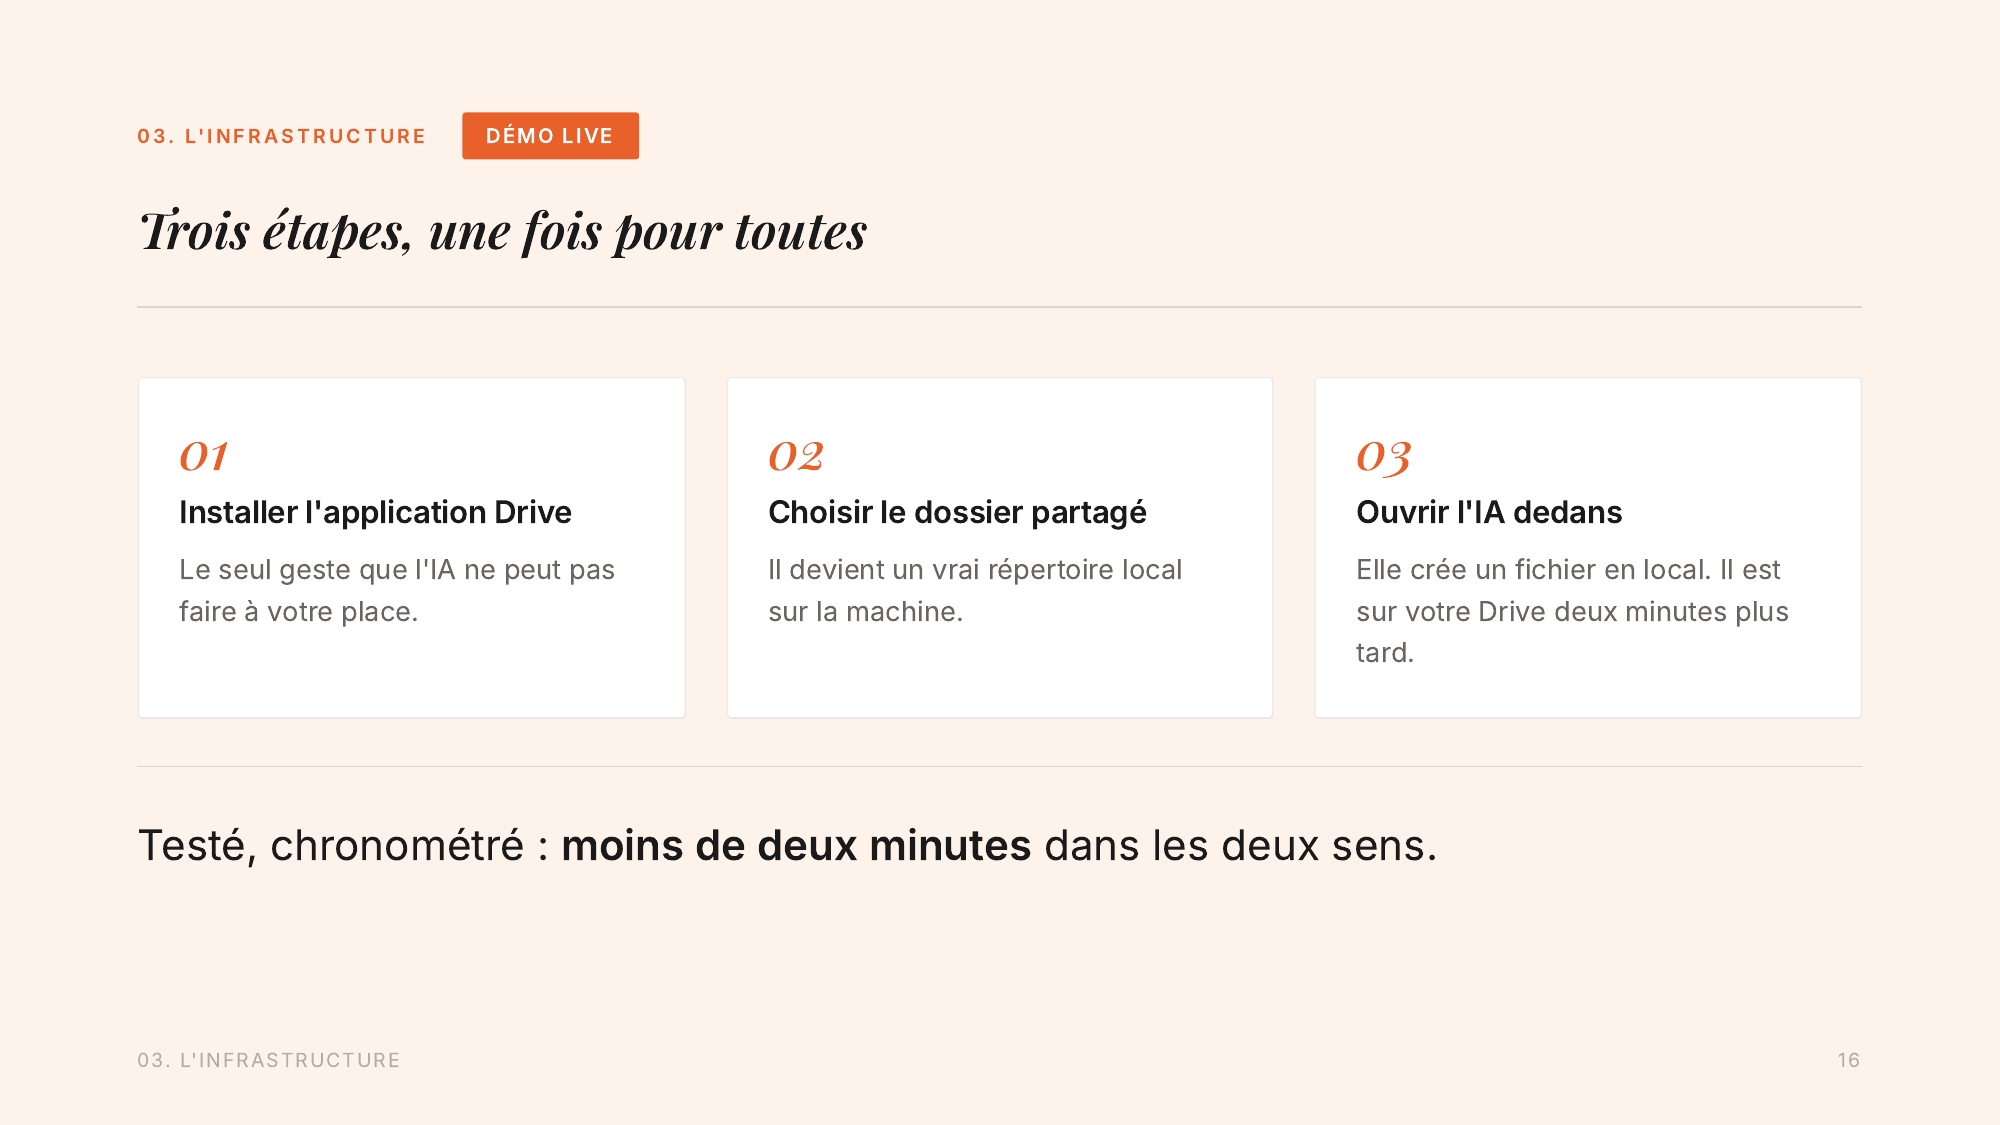
Concrètement, avec Google Drive, trois étapes une fois pour toutes : installer l’application de bureau, choisir le dossier partagé (il devient un miroir local sur votre machine), et ouvrir l’IA dedans. En lançant Claude Code depuis ce dossier, il charge automatiquement les fichiers de configuration et travaille en local, avec une synchronisation quasi instantanée vers le cloud. Testé et chronométré pendant le webinaire : moins de deux minutes dans les deux sens.
Pas besoin de connecteur ou de MCP pour ça : l’IA lit des fichiers locaux, ce qui est beaucoup plus efficace. La démo complète est dans le replay en haut de page.
Les deux pièges qui cassent le système en silence
Piège 1 : le raccourci invisible. Sur Drive, il est facile de créer des raccourcis vers un dossier partagé. Or un raccourci n’est pas téléchargé sur votre machine : l’IA n’y a pas accès. Un collaborateur qui reçoit le dossier commun par raccourci travaille avec un second cerveau silencieusement vide. Règle : jamais de raccourci, que des vrais dossiers téléchargés.
Piège 2 : les droits descendent. Donner accès à un dossier Drive, c’est donner accès à tout ce qu’il contient, par ruissellement. La conséquence pratique : un seul niveau de confidentialité dans le second cerveau, pas de pyramide. C’est acceptable parce qu’il ne contient que le contexte et les process, pas les documents sensibles : ceux-là restent dans votre Drive classique, avec sa gestion des droits habituelle. Pour un prestataire externe, on donne un accès granulaire au seul sous-dossier de son périmètre.
Le faire vivre : un responsable et quatre règles
Un second cerveau sans responsable se périme vite. C’est une posture de responsable qualité. Trois rôles : former les collaborateurs et les nouveaux arrivants, maintenir l’architecture (traquer les dossiers vides, les fiches périmées, les informations en double), et la faire évoluer avec le métier. L’IA peut aider avec des routines d’entretien, mais il faut un humain dont c’est la responsabilité, sinon c’est la responsabilité de personne.
Une distinction utile pour organiser tout ça : le process est ce que font les humains, la liste des étapes lisible par une personne, celle qu’on donne à un nouveau collaborateur. Le skill est la même chose pour l’IA : un fichier qu’elle exécute quand on en a besoin. Le process référence le skill, il ne le remplace pas. Quand vous documentez un process, vous ou l’IA pouvez identifier les parties automatisables et les transformer en skills.
Les quatre règles d’entretien :
- Une décision prise en réunion s’écrit le jour même. Sinon elle passe à la trappe, et c’est tout le système qui perd sa fiabilité.
- Un process qu’on a fait deux fois s’écrit. La deuxième fois, pas la cinquième. Il suffit de demander à l’IA : voici mon process, documente-le au bon endroit.
- Un département n’existe que s’il y a un process écrit. Un dossier vide dit que le système est mort. C’est là que se creusent les écarts de productivité entre équipes.
- Une information fausse se signale à son propriétaire. On ne la corrige pas en silence. Un fichier, un propriétaire : c’est lui qui tranche en cas de conflit.
Dernière subtilité, liée à l’absence de versionning sur un Drive : on ajoute, on ne réécrit pas. Un fichier supprimé ou écrasé l’est pour toujours, pour tout le monde. Quand une décision change, on ajoute une ligne datée en dessous (qui, quoi, pourquoi), on n’efface jamais la précédente. C’est l’historique du document qui fait sa valeur.
Pourquoi tout ça doit rester chez vous
Claude vit maintenant dans Slack : des agents accessibles en channel, que toute l’équipe peut solliciter, et qui accumulent une mémoire long terme sur votre entreprise. Honnêtement, c’est très bien fait. Sauf que cette mémoire, vous n’y avez aucun accès. Vous ne savez pas comment elle est organisée, vous ne pouvez pas l’exporter, et le jour où un autre fournisseur est meilleur, vous perdez d’un coup tout le contexte accumulé.
C’est le meilleur verrou qu’un fournisseur d’IA puisse avoir sur ses clients. La trajectoire est évidente : tout le monde a compris que ce contexte est ce qui a le plus de valeur. Le sujet, c’est de pouvoir partir avec vos données le jour où vous changez. L’hébergement, cloud ou local, a ses propres critères. Des fichiers texte dans un dossier que vous possédez, c’est le format le plus portable qui existe. Avec l’architecture de ce guide, passer de Claude à ChatGPT ou à un Mistral demain se fait sans friction, un enjeu qu’on avait déjà documenté côté dépendance à un fournisseur IA.
Et même sans IA : documenter ses process est la meilleure manière de rendre tout le monde plus productif, aujourd’hui, demain, dans dix ans. Ce travail de structuration de la connaissance de votre entreprise, il n’y a que vous qui pouvez le faire. Les outils dédiés qui émergeront ne le feront pas à votre place.
Le niveau 3, en vrai : notre système partagé
Notre espace commun, à deux : deux IA, deux machines, un seul système. Chacun a son second cerveau personnel (Obsidian + Git), et un dossier shared identique des deux côtés, synchronisé en temps réel. Un dossier par sujet avec l’historique des échanges ; à une étape clé, les documents basculent automatiquement dans le dossier suivant. Quand une modification part d’un côté, elle arrive de l’autre, fusionnée en temps réel même si on écrit tous les deux dans le même fichier.
On y arrive ensuite. La démo est dans le replay.
Vos six premiers pas
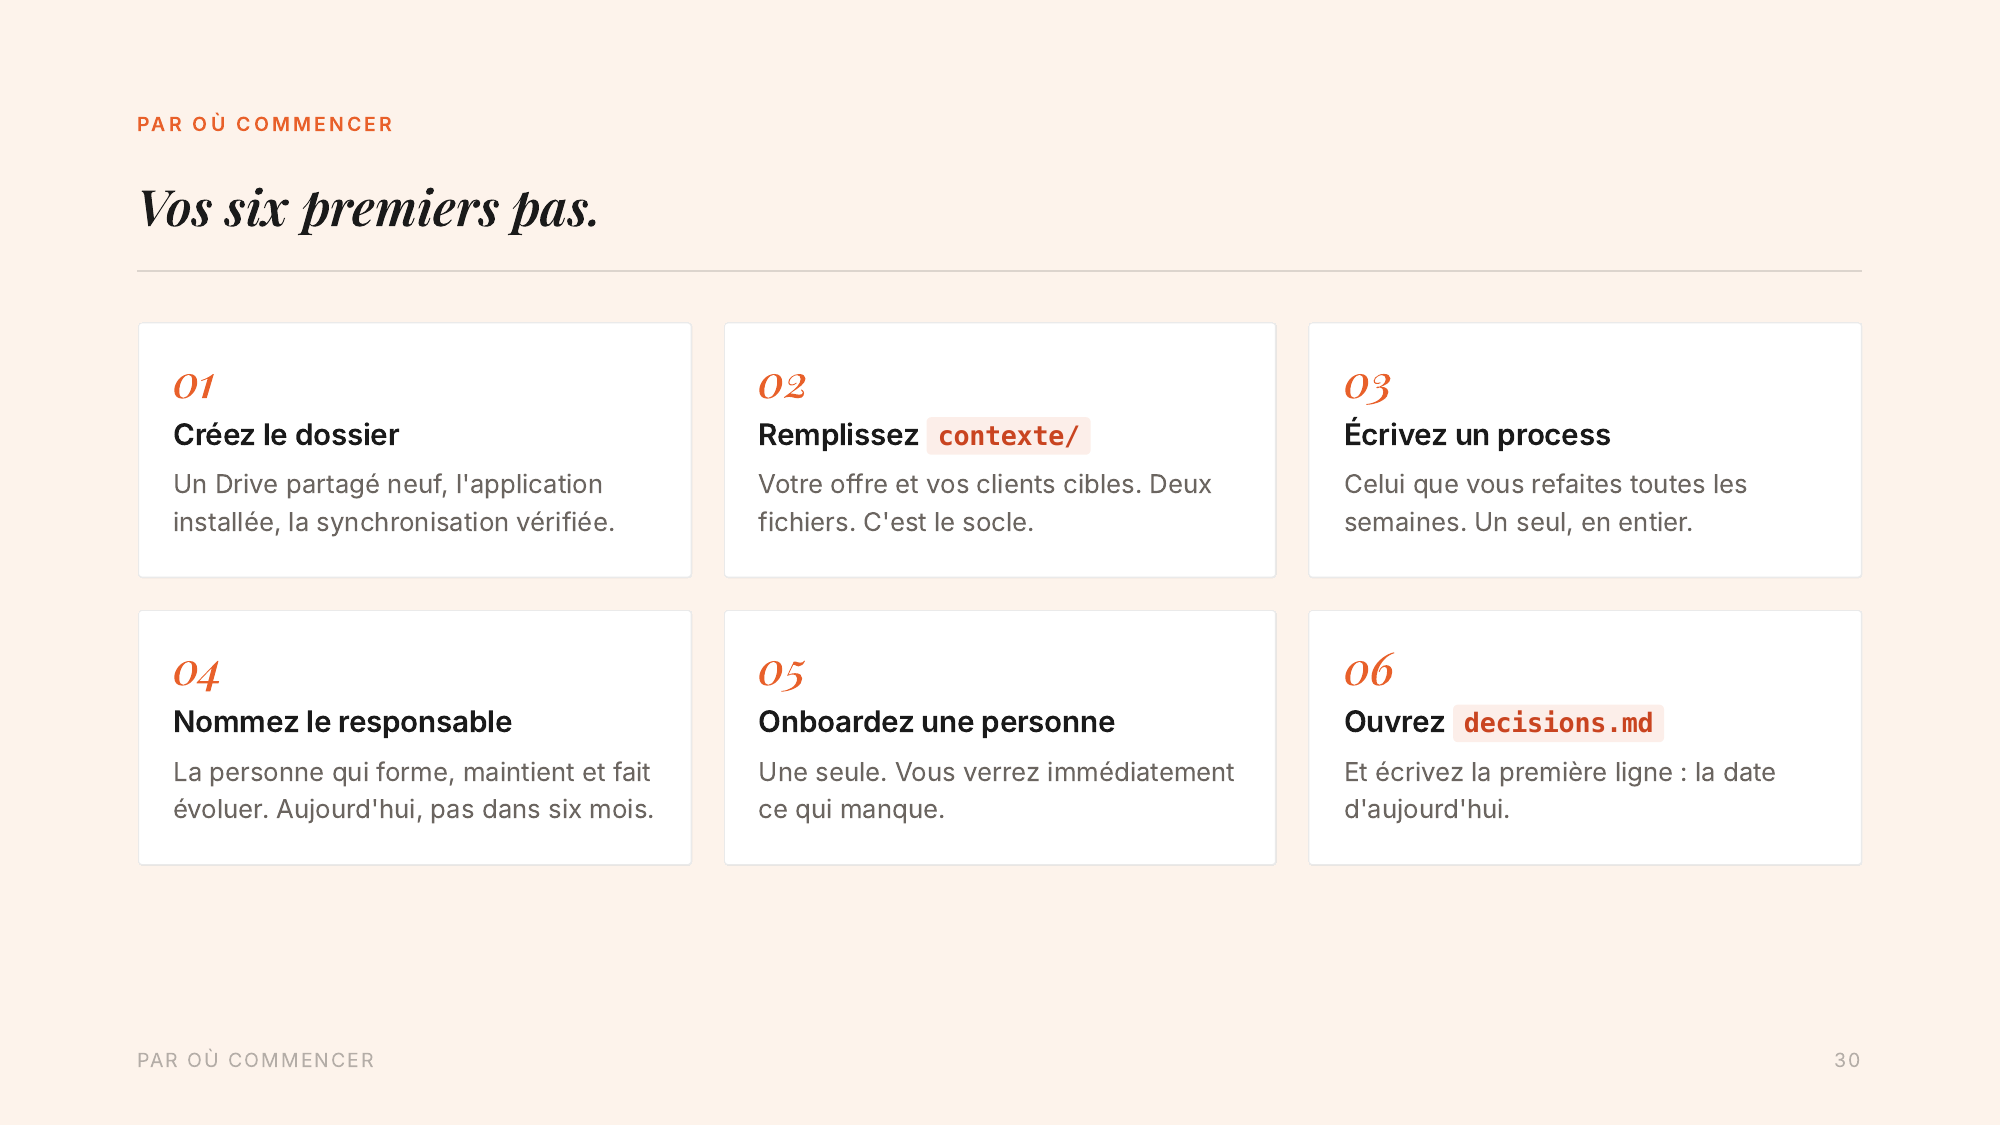
- Créez le dossier. Un Drive partagé neuf, l’application de bureau installée, la synchronisation vérifiée.
- Remplissez
contexte/. Votre offre et vos clients cibles. Deux fichiers. C’est le socle. - Écrivez un process. Celui que vous refaites toutes les semaines. Un seul, en entier.
- Nommez le responsable. La personne qui forme, maintient et fait évoluer. Aujourd’hui, pas dans six mois.
- Onboardez une personne. Une seule. Vous verrez immédiatement ce qui manque.
- Ouvrez
decisions.md. Et écrivez la première ligne : la date d’aujourd’hui.
Structurer, cartographier, documenter : il n’y a que vous qui pouvez le faire, et aucun outil ne le fera à votre place. Plus tôt vous commencez, plus tôt vous avez une longueur d’avance.
Le template, prêt à copier
Pour ne pas partir d’une page blanche, le dossier présenté pendant le webinaire est téléchargeable tel quel : la structure complète (contexte/, outils/, process/, clients/, equipe/), les CLAUDE.md déjà écrits avec les règles du système, et une trame à remplir pour chaque fichier (offre, clients cibles, ton, fiches outils, premier process). Dézippez-le dans un Drive partagé neuf, remplissez les champs entre accolades, supprimez les questions au fur et à mesure : c’est votre point de départ.
Télécharger le template (ZIP, 20 fichiers markdown)
La présentation du webinaire
Vous préférez les slides ? La présentation complète (32 slides) qui a servi de support au webinaire est disponible en téléchargement.
Télécharger la présentation (PDF)
FAQ
Quelle différence entre un dossier client du second cerveau et un CRM ?
Le second cerveau ne remplace pas le CRM, il le complète. Le CRM garde les informations commerciales structurées : deals, activités, montants. Le dossier client du second cerveau porte le contexte qualitatif que le CRM ne capte pas : depuis quand on travaille ensemble, qui intervient, ce qui a été décidé et quand. Il dit aussi à l’IA où chercher le reste (factures, documents de travail) au lieu de le stocker.
L’IA peut-elle créer ces fichiers de contexte à ma place ?
Oui, à condition que l’information existe quelque part : dans votre Drive, vos documents, vos outils. L’IA peut la retrouver et l’organiser dans le second cerveau. Pour ce qui n’est écrit nulle part, une méthode efficace consiste à demander à l’IA de vous interviewer sur les informations manquantes qu’elle n’a pas trouvées.
Comment maintenir le système sans que ce soit une usine à gaz ?
C’est une question de rigueur plus que de temps. Les process d’une entreprise ne changent pas tous les quatre matins : le cœur du système reste stable, seuls les dossiers vivants (décisions clients par exemple) bougent chaque semaine. Un responsable clairement identifié, aidé de routines IA d’entretien, suffit. Sans responsable, le système se périme vite.
Faut-il connecter Google Drive à Claude via un connecteur ?
Pas pour le second cerveau. Vous travaillez en local : l’application de bureau Google Drive synchronise automatiquement le dossier entre votre machine et le cloud. L’IA lit des fichiers locaux, ce qui est beaucoup plus rapide et fiable qu’un passage par un connecteur. Le connecteur reste utile pour chercher dans le reste de votre Drive.
Et la protection des données confidentielles ?
Deux niveaux. Entre collaborateurs : le second cerveau ne contient que les process et le contexte, pas les documents de production ; les informations sensibles restent dans votre Drive classique avec sa gestion des droits. Vis-à-vis du fournisseur d’IA : c’est le même arbitrage que pour votre usage quotidien, et les modèles open source ou hébergés localement fonctionnent avec la même architecture.
Comment donner accès à un prestataire externe sans tout partager ?
Les droits Google Drive descendent : donner accès au dossier racine donne accès à tout ce qu’il contient. Pour un prestataire, on donne un accès granulaire au seul sous-dossier de son périmètre (le dossier communication pour un prestataire com, par exemple). Il y trouve les process et le contexte de sa mission, rien d’autre.
Vous voulez avancer ?
On construit les systèmes IA
que vos équipes pilotent.
Deux praticiens IA-natifs. Des résultats tangibles, chaque semaine.